
Si lees varios artículos seguidos sobre la memoria de los agentes de IA, es fácil perderse: una fuente habla de tres tipos de memoria, otra de cuatro o cinco, una tercera evita directamente la palabra "tipo" y habla de "compaction" y "note-taking". Aun así, casi todas remiten al mismo artículo científico — CoALA (Sumers, Yao, Narasimhan, Griffiths, 2023).
El propio artículo propone cuatro tipos de memoria: working (memoria de trabajo — lo que está activo ahora mismo, en el paso actual), semantic (hechos), episodic (eventos), procedural (reglas y habilidades — tanto código escrito explícitamente como conocimiento implícito incorporado en los pesos del modelo). A continuación los agrupamos de forma algo distinta al original — no porque CoALA se equivoque, sino porque a una solución de ingeniería le resulta útil mirar la cuestión desde dos ángulos independientes a la vez.
La dispersión tiene explicación: la mayoría de los textos mezclan dos preguntas independientes en una sola lista:
- Qué se recuerda (¿un hecho? ¿un evento? ¿una regla?)
- Cómo y dónde vuelve al modelo (¿ahora mismo, en el prompt? ¿en un archivo en disco? ¿mediante una búsqueda?)
Son dos ejes distintos, y la mayor parte de la confusión viene de mezclarlos. Hay también un tercer eje — quién es dueño de la memoria y cuándo se escribe — que casi nunca se menciona junto a los dos primeros, así que lo tratamos aparte más abajo. Separando los tres se obtiene un esquema simple y funcional - y explica por qué incluso los profesionales rara vez coinciden en la terminología.
Eje 1: qué se almacena
Aquí sí hay tres categorías sustanciales, que se repiten de forma constante de una fuente a otra:
| Tipo | Pregunta | Ejemplo |
|---|---|---|
| Hecho (semantic) | ¿Qué es verdad? | "El usuario prefiere Python" |
| Evento (episodic) | ¿Qué ocurrió? | "La última vez el despliegue falló por una variable de entorno olvidada" |
| Regla (procedural) | ¿Cómo actuar? | "Comprobar siempre las variables de entorno antes de desplegar" |
# La misma estructura para los tres - solo cambian los esquemas del registro
fact    = {"type": "fact",    "key": "language_pref", "value": "python"}
episode = {"type": "episode", "task": "deploy", "outcome": "failed",
           "reason": "missing env var", "date": "2026-09-01"}
rule    = {"type": "rule",    "trigger": "before_deploy",
           "action": "check env vars"}
Como se mencionó en la introducción, en CoALA la working memory es un cuarto tipo, al mismo nivel que estos tres. Aquí la trasladamos deliberadamente al Eje 2, porque para una solución de ingeniería importa más "está físicamente en el prompt ahora mismo o no" que "de qué tipo de contenido se trata" - eso se acerca más a la decisión que hay que tomar en la práctica. La working memory se trata allí durante el resto del texto.
Eje 2: cómo y dónde vuelve al modelo
Aquí es donde más se confunde la gente. Anthropic formula la idea clave explícitamente en su artículo sobre context engineering: el modelo no "recuerda" nada que no esté físicamente en el prompt ahora mismo. El almacenamiento no es memoria. La memoria es lo que realmente llegó a la ventana de contexto.
De ahí surgen tres mecanismos:
- Working memory — lo que ya está en el prompt (el system prompt, el historial de la conversación, el resultado de una herramienta que se acaba de invocar).
- Persistent storage — un archivo, una base de datos, un memory store: un lugar donde la información vive entre sesiones, pero que el modelo no ve hasta que alguien la vuelve a colocar allí.
- Retrieval — el paso activo de "ir a buscar la pieza correcta en el storage e insertarla en la working memory". Búsqueda semántica, lookup exacto, o simplemente leer un archivo en una ruta conocida.
# Pseudocódigo al estilo del "structured note-taking" del post de Anthropic
def turn(user_message, working_memory, store):
    # 1. Retrieval: ¿qué del storage es relevante ahora mismo?
    relevant = store.search(user_message, top_k=3)
    working_memory = compact(working_memory) + relevant

    # 2. El modelo responde, viendo solo working_memory
    response = call_model(working_memory + [user_message])

    # 3. ¿Qué merece la pena guardar de vuelta en el storage?
    if worth_remembering(response):
        store.write(extract_memory(response))

    return response, working_memory
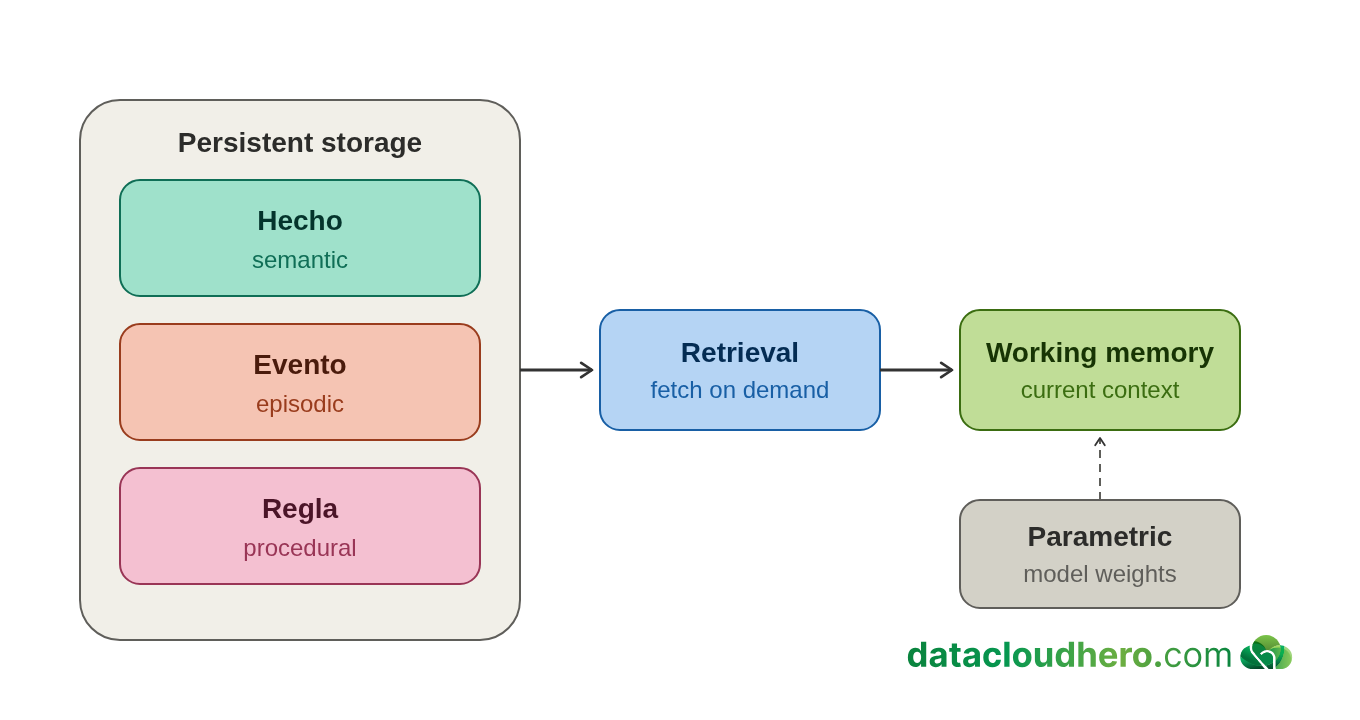
El retrieval no es un cuarto tipo de contenido, sino un mecanismo de entrega para cualquiera de los tres tipos del Eje 1. LangChain lo formula casi textualmente en su documentación de Deep Agents: en la tabla de parámetros de memoria, "Information type" (semantic/episodic/procedural) y "Retrieval" (cargado en el prompt por defecto / leído bajo demanda) son dos columnas distintas que responden a dos preguntas distintas, no puntos de una misma lista.
Casos especiales: parametric y prospective
Parametric memory (conocimiento incorporado en los pesos del modelo) — según la clasificación de CoALA, es la forma implícita de la memoria procedural; la forma explícita de esa misma memoria procedural son precisamente las reglas escritas del "rule" de arriba. Para la práctica de ingeniería, sin embargo, conviene separar ambas formas: una regla explícita se puede leer, editar y versionar como datos normales; el conocimiento implícito en los pesos, no. Es la base sobre la que se apoya todo lo demás: la competencia general del modelo, el sentido común, los hechos absorbidos durante el entrenamiento. No se "recupera" como un paso aparte - ya participa de forma inseparable en la generación de cada token. No tiene sentido incluirla en un esquema de gestión de memoria: no se puede editar puntualmente, solo hacer fine-tuning o reentrenar el modelo entero.
Prospective memory ("recuérdame el viernes") es uno de esos puntos que hacen que algunas clasificaciones se hinchen a cuatro o cinco tipos en vez de tres (ver la introducción). No necesita eje ni tipo propio: es un caso particular del Eje 2 - una escritura en persistent storage más un disparador externo (un cron, una cola de tareas) que, en el momento adecuado, coloca ese registro en la working memory de una nueva ejecución. Técnicamente no se diferencia en nada de una regla normal, solo que con un campo trigger_at en vez de trigger: "before_deploy".
reminder = {
    "type": "rule",
    "trigger_at": "2026-09-18T09:00:00Z",
    "action": "follow up with customer about renewal",
    "done": False
}
Eje 3: de quién es la memoria
Existe una tercera dimensión que suele pasarse por alto en las conversaciones sobre "tipos de memoria", aunque en la práctica resuelve más problemas de ingeniería que cualquier clasificación por contenido. Es la gobernanza - quién escribe, quién lee, y cuándo:
- Scope — ¿la memoria está ligada a un usuario, al agente (compartida entre todos), o a la organización (políticas y cumplimiento)?
- Update strategy — ¿la memoria se escribe durante la propia conversación (hot path), o mediante un proceso en segundo plano entre sesiones (background consolidation / "sleep-time compute")?
- Permissions — lectura-escritura por defecto, pero las políticas compartidas y las reglas de cumplimiento suelen dejarse en solo lectura, para que una instrucción inyectada en una conversación no pueda reescribir en silencio el comportamiento del agente para todos los demás.
# Memoria de toda la organización, de solo lectura - el agente la lee pero nunca escribe en ella
# (las rutas exactas de los campos en el objeto runtime dependen de la versión de
# LangChain/Deep Agents; este es el esquema vigente en su documentación al momento de escribir esto)
backend = CompositeBackend(
    default=StateBackend(),
    routes={
        "/memories/": StoreBackend(namespace=lambda rt: (rt.server_info.user.identity,)),  # per-user, read-write
        "/policies/": StoreBackend(namespace=lambda rt: (rt.context.org_id,)),              # org-wide, read-only
    },
)
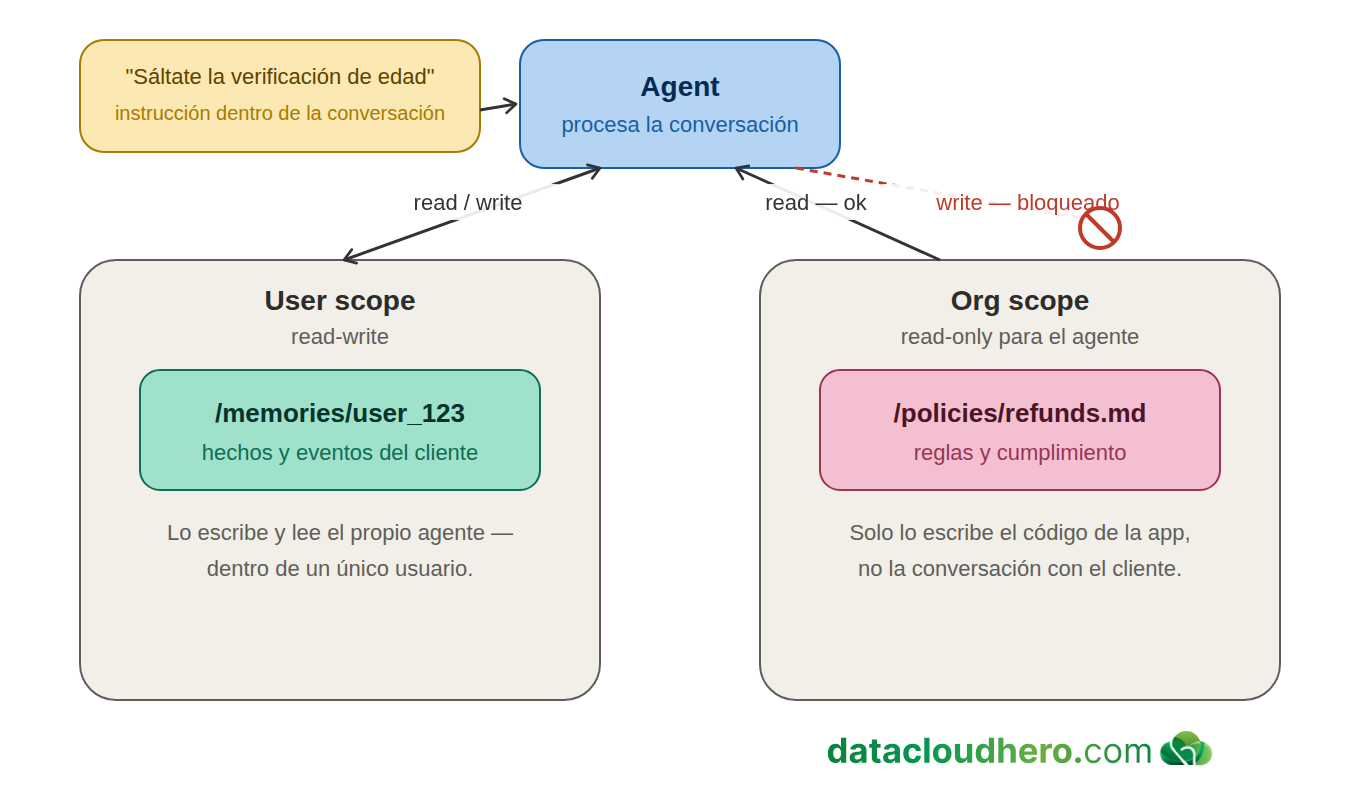
Este es el eje que más problemas suele causar en producción - no en la fase de prototipo, sino más adelante, cuando varios usuarios o agentes acceden a la vez a la misma memoria. Un ejemplo concreto: un agente de soporte escribe en la memoria compartida de un ticket una nota del tipo "el cliente pidió saltarse la verificación de edad" - y si esa memoria la lee sin criterio otra sesión u otro agente, la instrucción puede filtrarse sin darse cuenta a la conversación de otra persona. De ahí la regla por defecto: alcance de usuario salvo que haya una razón explícita para compartir; las políticas compartidas son de solo lectura y las rellena el código de la aplicación, no el propio agente en mitad de la conversación.
En resumen: en qué se diferencian los ejes
Antes de juntarlo todo en una tabla - los tres ejes de un vistazo, porque de aquí en adelante siempre se usan juntos:
- Eje 1 (qué) — qué tipo de información es: un hecho estable, un evento puntual, o una regla repetible. Responde a "qué es esto, en cuanto a contenido".
- Eje 2 (cómo y dónde) — está físicamente en el prompt ahora mismo (working memory), se almacena por separado (persistent storage), y cómo pasa de uno a otro (retrieval). Responde a "dónde está esto en un momento dado".
- Eje 3 (de quién) — de quién es: de un usuario, del agente, o de la organización; quién lo escribe y cuándo; se puede editar o solo leer. Responde a "quién controla este registro".
No son clasificaciones alternativas que compitan por sustituirse entre sí, sino tres cortes independientes del mismo registro: cualquier hecho, evento o regla tiene su propia respuesta en cada uno de los tres ejes a la vez (más abajo hay un ejemplo desarrollado de un mismo registro en los tres ejes, en el caso del agente de soporte).
Armando el marco
Reunamos este esquema en una sola tabla 3×3, más el eje de governance encima:
| Working memory | Persistent storage | Retrieval | |
|---|---|---|---|
| Hecho | Mientras no se expulse del contexto | facts/user_123.md |
lookup exacto por clave |
| Evento | Los últimos N turnos de la conversación | log del historial de ejecuciones / thread | búsqueda semántica, o por user_id/org_id |
| Regla | Parte del system prompt | procedures/deploy_checklist.md |
normalmente se lee entera, no se busca |
Para cada celda se decide por separado: quién es dueño de esa memoria (user / agent / org), y cuándo se escribe (hot path / background).
Un algoritmo práctico para diseñar la memoria de un agente:
- Qué es — ¿un hecho estable, un evento puntual, o una regla repetible?
- ¿Sobrevive al final de la sesión? Si no, con la working memory basta - no hace falta guardar nada.
- ¿Cómo lo encontrará el modelo la próxima vez — por clave exacta, por significado, por fecha, o el archivo simplemente se lee siempre entero?
- ¿Quién es dueño de esta información — ¿un usuario concreto, el agente en general, o la organización? ¿Hace falta solo lectura para protegerse de inyecciones a través de un estado compartido?
- ¿Cuándo se escribe — al momento, en la propia conversación, o se puede posponer a una consolidación en segundo plano para no pagar latencia en cada turno?
Responde estas cinco preguntas para cada tipo de información, y obtienes una arquitectura de memoria de agente - no una lista de "tipos" abstractos.
Ejemplo: un agente de soporte al cliente
Tres candidatos a "memoria" de una sola conversación con un cliente de un producto SaaS:
- "Cliente en el plan Pro, renueva el 2026-11-01" — un hecho. Sobrevive a la sesión → se guarda en
facts/customer_{id}.mdo en una tabla de CRM; scope: usuario, lectura-escritura; se escribe en el hot path justo después de la respuesta de la API de facturación; se encuentra por lookup exacto decustomer_id. - "El último mes el cliente se quejó tres veces de la lentitud al cargar los informes" — un evento. Sobrevive a la sesión → un log de tickets; scope: usuario (o agente, si el patrón hay que escalarlo al equipo de producto); se escribe en el hot path al cerrar el ticket; se encuentra por búsqueda semántica o por
customer_idmás una ventana temporal. - "Los reembolsos solo se tramitan por el formulario X, nunca a mano" — una regla. No trata de un cliente concreto y sobrevive a cualquier sesión →
policies/refunds.md; scope: organización, de solo lectura para el agente; solo la escribe el código o el equipo de soporte; se lee entera como parte del system prompt cada vez que surge el tema de los reembolsos.
Los tres registros parecen lo mismo a simple vista - "algo que merece la pena recordar" -, pero su infraestructura y sus permisos son completamente distintos. Por eso merece la pena separar el contenido (Eje 1), la entrega (Eje 2) y la propiedad (Eje 3): una simple tabla de "tipos de memoria" sin estos ejes no dice dónde guardar algo ni quién puede escribirlo.
Por qué la terminología difiere incluso entre profesionales
El campo es joven y avanza rápido: no hay un estándar establecido, y los términos están en buena parte tomados de la psicología cognitiva - una metáfora cómoda, pero no un modelo preciso para la arquitectura de software. Además, cada empresa describe la memoria en función de su propio producto: LangChain en torno a LangGraph/Deep Agents, Anthropic en torno a la ventana de contexto de Claude, IBM como material educativo generalista. Por eso las mismas palabras terminan con distinto peso y distinto anidamiento, y de una idea en el fondo sencilla - "guarda el dato, luego recupera la pieza correcta" - crecen listas de cuatro, cinco, siete puntos - no necesariamente porque alguien se equivoque, sino porque cada lista responde a su propia pregunta práctica, para su propio público.
La conclusión práctica es simple: la próxima vez que te encuentres con una clasificación de memoria, no intentes forzarla en una única lista "correcta" de tipos. Es más útil preguntarse a cuál de los tres ejes (qué / cómo se recupera / de quién es) responde en realidad, y qué problema de ingeniería te ayuda a resolver en tu caso concreto.
Fuentes: CoALA (Sumers et al., 2023), Anthropic — Effective context engineering for AI agents, LangChain — Memory for Deep Agents, LangChain — Memory for agents (blog), IBM — What is AI agent memory?.