
Liest man mehrere Artikel zum Thema Gedächtnis von KI-Agenten hintereinander, verliert man schnell den Überblick: Die eine Quelle spricht von drei Gedächtnisarten, die nächste von vier oder fünf, eine dritte verzichtet ganz auf das Wort „Typ" und spricht stattdessen von „Compaction" und „Note-Taking". Fast alle beziehen sich dabei jedoch auf dieselbe wissenschaftliche Arbeit — CoALA (Sumers, Yao, Narasimhan, Griffiths, 2023).
Das Paper selbst schlägt vier Gedächtnistypen vor: working (Arbeitsgedächtnis — das, was gerade jetzt, im aktuellen Schritt, aktiv ist), semantic (Fakten), episodic (Ereignisse), procedural (Regeln und Fertigkeiten — sowohl explizit geschriebener Code als auch implizites Wissen, das in den Gewichten des Modells steckt). Im Folgenden gruppieren wir diese etwas anders als im Original — nicht weil CoALA falsch liegt, sondern weil es für eine technische Lösung hilfreich ist, die Frage gleichzeitig aus zwei unabhängigen Blickwinkeln zu betrachten.
Die Streuung lässt sich erklären: Die meisten Texte vermischen zwei unabhängige Fragen in einer Liste:
- Was wird gespeichert (ein Fakt? ein Ereignis? eine Regel?)
- Wie und wo kommt es zum Modell zurück (gerade jetzt, im Prompt? in einer Datei auf der Festplatte? über eine Suche?)
Das sind zwei verschiedene Achsen, und der größte Teil der Verwirrung entsteht durch ihre Vermischung. Es gibt noch eine dritte Achse — wem das Gedächtnis gehört und wann es geschrieben wird —, die fast nie zusammen mit den ersten beiden genannt wird; deshalb behandeln wir sie weiter unten gesondert. Trennt man alle drei, ergibt sich ein einfaches, praxistaugliches Schema — und es erklärt, warum sich selbst Fachleute selten auf eine Terminologie einigen.
Achse 1: Was gespeichert wird
Hier gibt es tatsächlich drei inhaltliche Kategorien, die sich von Quelle zu Quelle konstant wiederholen:
| Typ | Frage | Beispiel |
|---|---|---|
| Fakt (semantic) | Was ist wahr? | „Der Nutzer bevorzugt Python" |
| Ereignis (episodic) | Was ist passiert? | „Beim letzten Mal ist das Deployment wegen einer vergessenen Umgebungsvariable fehlgeschlagen" |
| Regel (procedural) | Wie soll gehandelt werden? | „Vor jedem Deployment immer die Umgebungsvariablen prüfen" |
# Dieselbe Struktur für alle drei - nur unterschiedliche Datensatzformen
fact    = {"type": "fact",    "key": "language_pref", "value": "python"}
episode = {"type": "episode", "task": "deploy", "outcome": "failed",
           "reason": "missing env var", "date": "2026-09-01"}
rule    = {"type": "rule",    "trigger": "before_deploy",
           "action": "check env vars"}
Wie einleitend erwähnt, ist working memory bei CoALA ein vierter, gleichrangiger Typ neben diesen dreien. Wir verschieben es bewusst auf Achse 2, denn für eine technische Lösung zählt weniger „welche Art von Inhalt ist das", sondern „liegt es gerade physisch im Prompt oder nicht" — das kommt der Entscheidung, die in der Praxis wirklich zu treffen ist, näher. Working memory wird im weiteren Verlauf dort behandelt.
Achse 2: Wie und wo es zum Modell zurückkommt
Hier entsteht die größte Verwirrung. Anthropic bringt den Kerngedanken in seinem Beitrag zum Context Engineering klar auf den Punkt: Das Modell „erinnert" sich an nichts, was nicht gerade physisch im Prompt steht. Speicherung ist noch keine Erinnerung. Erinnerung ist das, was tatsächlich ins Kontextfenster gelangt ist.
Daraus ergeben sich drei Mechanismen:
- Working memory — das, was bereits im Prompt steht (System-Prompt, Gesprächsverlauf, das gerade aufgerufene Tool-Ergebnis).
- Persistent storage — eine Datei, eine Datenbank, ein Memory Store: ein Ort, an dem Informationen zwischen Sitzungen weiterbestehen, den das Modell aber nicht sieht, solange niemand sie zurücklegt.
- Retrieval — der aktive Schritt, „das richtige Stück aus dem Storage zu holen und ins Working Memory einzufügen". Semantische Suche, exakter Lookup, oder einfach das Lesen einer Datei unter bekanntem Pfad.
# Pseudocode im Sinne des "structured note-taking" aus dem Anthropic-Beitrag
def turn(user_message, working_memory, store):
    # 1. Retrieval: Was ist aus dem Storage gerade relevant?
    relevant = store.search(user_message, top_k=3)
    working_memory = compact(working_memory) + relevant

    # 2. Das Modell antwortet und sieht dabei nur working_memory
    response = call_model(working_memory + [user_message])

    # 3. Was lohnt sich, zurück in den Storage zu schreiben?
    if worth_remembering(response):
        store.write(extract_memory(response))

    return response, working_memory
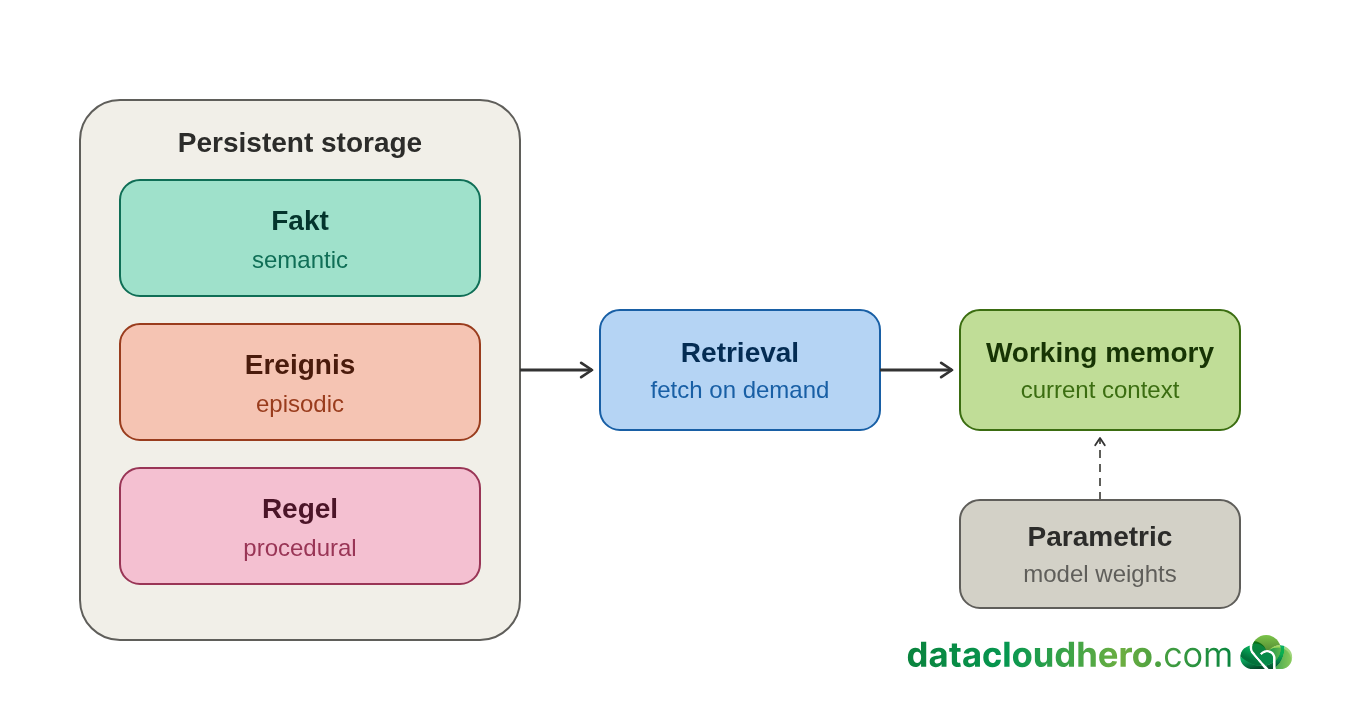
Retrieval ist kein vierter Inhaltstyp, sondern ein Zustellmechanismus für jeden der drei Typen aus Achse 1. LangChain formuliert das in der Deep-Agents-Dokumentation fast wortgleich: In der Tabelle der Memory-Parameter sind „Information type" (semantic/episodic/procedural) und „Retrieval" (standardmäßig in den Prompt geladen / bei Bedarf gelesen) zwei getrennte Spalten, die zwei getrennte Fragen beantworten — nicht Punkte derselben Liste.
Sonderfälle: parametric und prospective
Parametric memory (Wissen, das in den Gewichten des Modells steckt) — nach der Klassifikation von CoALA ist das die implizite Form des prozeduralen Gedächtnisses; die explizite Form desselben prozeduralen Gedächtnisses sind genau die oben geschriebenen „rule"-Regeln. Für die technische Praxis lohnt es sich trotzdem, beide Formen zu trennen: Eine explizite Regel lässt sich lesen, bearbeiten und versionieren wie gewöhnliche Daten; implizites Wissen in den Gewichten nicht. Das ist das Fundament, auf dem alles andere aufbaut: die allgemeine Kompetenz des Modells, gesunder Menschenverstand, während des Trainings aufgenommene Fakten. Es wird nicht als separater Schritt „abgerufen" — es ist bereits untrennbarer Bestandteil der Erzeugung jedes einzelnen Tokens. In ein Memory-Management-Schema gehört es nicht: gezielt bearbeiten lässt es sich nicht, nur per Fine-Tuning oder komplettem Neutraining des Modells verändern.
Prospective memory („erinnere mich am Freitag") ist einer der Punkte, die manche Klassifikationen auf vier oder fünf Typen statt drei aufblähen (siehe Einleitung). Eine eigene Achse oder einen eigenen Typ braucht es dafür nicht: Es ist ein Sonderfall von Achse 2 — ein Schreibvorgang in den Persistent Storage plus ein externer Trigger (Cron-Job, Task-Queue), der den Eintrag zum richtigen Zeitpunkt in das Working Memory eines neuen Laufs legt. Technisch unterscheidet sich das in nichts von einer gewöhnlichen Regel — nur mit einem trigger_at-Feld statt trigger: "before_deploy".
reminder = {
    "type": "rule",
    "trigger_at": "2026-09-18T09:00:00Z",
    "action": "follow up with customer about renewal",
    "done": False
}
Achse 3: Wem das Gedächtnis gehört
Es gibt eine dritte Dimension, die in Gesprächen über „Gedächtnistypen" meist übersehen wird, obwohl sie in der Praxis mehr technische Probleme löst als jede inhaltliche Klassifikation. Das ist Governance — wer schreibt, wer liest, und wann:
- Scope — ist das Gedächtnis an einen Nutzer gebunden, an den Agenten (für alle gemeinsam), oder an die Organisation (Richtlinien und Compliance)?
- Update strategy — wird das Gedächtnis direkt während des Gesprächs geschrieben (Hot Path), oder durch einen separaten Hintergrundprozess zwischen den Sitzungen (Background Consolidation / „Sleep-Time Compute")?
- Permissions — standardmäßig Lese-/Schreibzugriff, aber gemeinsame Richtlinien und Compliance-Regeln werden meist read-only gemacht, damit eine im Gespräch eingeschleuste Anweisung nicht heimlich das Verhalten des Agenten für alle anderen umschreiben kann.
# Organisationsweites Gedächtnis ist read-only - der Agent liest es, schreibt aber nie hinein
# (die genauen Feldpfade am Runtime-Objekt hängen von der LangChain/Deep-Agents-Version ab;
# hier das zum Zeitpunkt des Schreibens aktuelle Schema aus deren Doku)
backend = CompositeBackend(
    default=StateBackend(),
    routes={
        "/memories/": StoreBackend(namespace=lambda rt: (rt.server_info.user.identity,)),  # per-user, read-write
        "/policies/": StoreBackend(namespace=lambda rt: (rt.context.org_id,)),              # org-wide, read-only
    },
)
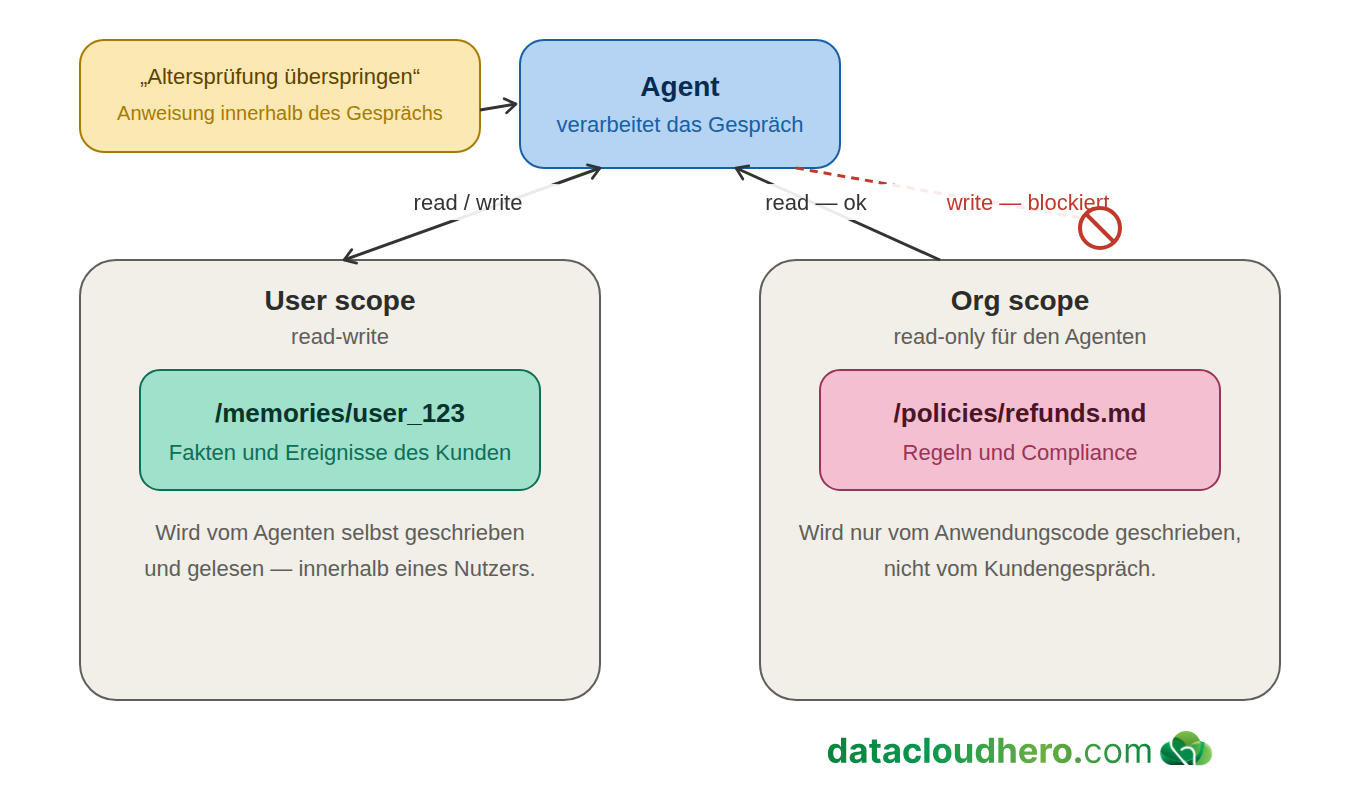
Genau diese Achse verursacht in Produktion am häufigsten Probleme - nicht in der Prototyp-Phase, sondern später, sobald mehrere Nutzer oder Agenten gleichzeitig Zugriff auf dasselbe Gedächtnis bekommen. Ein konkretes Beispiel: Ein Support-Agent schreibt in das gemeinsame Ticket-Gedächtnis eine Notiz wie „Kunde hat gebeten, die Altersprüfung zu überspringen" — und wenn diese Erinnerung unterschiedslos von anderen Sitzungen oder einem anderen Agenten gelesen wird, kann die Anweisung unbemerkt in ein fremdes Gespräch durchsickern. Daraus ergibt sich die Standardregel: Scope auf den Nutzer, sofern es keinen expliziten Grund zum Teilen gibt; gemeinsame Richtlinien sind read-only und werden von Anwendungscode befüllt, nicht vom Agenten selbst mitten im Gespräch.
Kurz gesagt: worin sich die Achsen unterscheiden
Bevor alles in einer Tabelle zusammenläuft — die drei Achsen auf einen Blick, denn danach werden sie durchgehend gemeinsam verwendet:
- Achse 1 (was) — um welche Art von Information es geht: ein stabiler Fakt, ein einmaliges Ereignis, oder eine wiederholbare Regel. Beantwortet die Frage „was ist das inhaltlich".
- Achse 2 (wie und wo) — liegt es gerade physisch im Prompt (working memory), wird es getrennt gespeichert (persistent storage), und wie gelangt es von einem zum anderen (retrieval). Beantwortet die Frage „wo befindet sich das gerade".
- Achse 3 (wessen) — wem es gehört: einem Nutzer, dem Agenten, oder der Organisation; wer es schreibt und wann; lässt es sich bearbeiten oder nur lesen. Beantwortet die Frage „wer kontrolliert diesen Eintrag".
Das sind keine alternativen Klassifikationen, die einander ersetzen sollen, sondern drei unabhängige Schnitte durch denselben Eintrag: Jeder Fakt, jedes Ereignis, jede Regel hat auf jeder der drei Achsen gleichzeitig eine eigene Antwort (ein durchgerechnetes Beispiel eines einzelnen Eintrags über alle drei Achsen folgt weiter unten, im Support-Agent-Fall).
Das Framework zusammensetzen
Fassen wir dieses Schema in einer einzigen 3×3-Tabelle zusammen, plus der Governance-Achse obendrauf:
| Working memory | Persistent storage | Retrieval | |
|---|---|---|---|
| Fakt | Solange es nicht aus dem Kontext verdrängt wird | facts/user_123.md |
exakter Lookup per Schlüssel |
| Ereignis | Letzte N Runden des Gesprächs | Log vergangener Läufe / Thread-Historie | semantische Suche, oder nach user_id/org_id |
| Regel | Teil des System-Prompts | procedures/deploy_checklist.md |
wird meist vollständig gelesen, nicht gesucht |
Für jede Zelle wird separat entschieden: Wem gehört dieses Gedächtnis (user / agent / org), und wann wird es geschrieben (hot path / background).
Ein praktischer Ablauf für den Entwurf des Gedächtnisses eines Agenten:
- Was ist es — ein stabiler Fakt, ein einmaliges Ereignis, oder eine wiederholbare Regel?
- Überlebt es das Ende der Sitzung? Wenn nicht — working memory reicht, nichts muss gespeichert werden.
- Wie findet das Modell es beim nächsten Mal — über einen exakten Schlüssel, inhaltlich, zeitlich, oder wird die Datei einfach immer komplett gelesen?
- Wem gehört diese Information — einem bestimmten Nutzer, dem Agenten insgesamt, oder der Organisation? Braucht es read-only, um sich gegen Injektionen über geteilten State abzusichern?
- Wann wird es geschrieben — sofort im Gespräch, oder lässt es sich auf eine Hintergrundkonsolidierung verschieben, um nicht bei jedem Zug Latenz zu verbrauchen?
Diese fünf Fragen für jede Art von Information beantwortet, ergibt eine Gedächtnisarchitektur für Agenten - keine Liste abstrakter „Typen".
Beispiel: ein Kundensupport-Agent
Drei Kandidaten für „Gedächtnis" aus einem einzigen Gespräch mit einem SaaS-Kunden:
- „Kunde im Pro-Tarif, Verlängerung am 2026-11-01" — ein Fakt. Überlebt die Sitzung → gespeichert in
facts/customer_{id}.mdoder einer CRM-Tabelle; Scope: Nutzer, Lese-/Schreibzugriff; geschrieben im Hot Path direkt nach der Antwort der Billing-API; gefunden per exaktemcustomer_id-Lookup. - „Im letzten Monat hat sich der Kunde dreimal über langsam ladende Reports beschwert" — ein Ereignis. Überlebt die Sitzung → ein Ticket-Log; Scope: Nutzer (oder Agent, falls das Muster ans Produktteam eskaliert werden muss); geschrieben im Hot Path beim Schließen des Tickets; gefunden per semantischer Suche oder per
customer_idplus Zeitfenster. - „Rückerstattungen laufen nur über Formular X, nie manuell" — eine Regel. Sie betrifft keinen bestimmten Kunden und überlebt jede Sitzung →
policies/refunds.md; Scope: Organisation, für den Agenten read-only; wird nur von Code oder vom Support-Team geschrieben; wird vollständig als Teil des System-Prompts gelesen, sobald das Thema Rückerstattung aufkommt.
Die drei Einträge wirken oberflächlich gleich - „etwas, das man sich merken sollte" -, aber ihre Infrastruktur und ihre Berechtigungen unterscheiden sich völlig. Genau deshalb lohnt es sich, Inhalt (Achse 1), Zustellung (Achse 2) und Eigentümerschaft (Achse 3) getrennt zu betrachten: Eine einzelne „Gedächtnistyp"-Tabelle ohne diese Achsen sagt weder, wo etwas gespeichert wird, noch, wer schreiben darf.
Warum die Terminologie selbst unter Fachleuten auseinandergeht
Das Feld ist jung und entwickelt sich schnell: Es gibt keinen etablierten Standard, und die Begriffe sind größtenteils aus der Kognitionspsychologie entlehnt - eine praktische Metapher, aber kein präzises Modell für Softwarearchitektur. Hinzu kommt, dass jedes Unternehmen Gedächtnis rund um sein eigenes Produkt beschreibt: LangChain rund um LangGraph/Deep Agents, Anthropic rund um das Kontextfenster von Claude, IBM als allgemeines Lehrmaterial. So bekommen dieselben Wörter unterschiedliches Gewicht und unterschiedliche Verschachtelung, und aus der im Grunde simplen Idee „Daten speichern, dann das richtige Stück wieder herausholen" wachsen Listen mit vier, fünf, sieben Punkten - nicht unbedingt, weil jemand sich irrt, sondern weil jede Liste ihre eigene praktische Frage für ihr eigenes Publikum beantwortet.
Die praktische Schlussfolgerung ist einfach: Wenn Ihnen das nächste Mal eine Gedächtnisklassifikation begegnet, versuchen Sie nicht, sie in eine „richtige" Liste von Typen zu pressen. Nützlicher ist die Frage, welche der drei Achsen (was / wie es abgerufen wird / wem es gehört) sie eigentlich beantwortet, und welches technische Problem sie in Ihrem konkreten Fall löst.
Quellen: CoALA (Sumers et al., 2023), Anthropic — Effective context engineering for AI agents, LangChain — Memory for Deep Agents, LangChain — Memory for agents (blog), IBM — What is AI agent memory?.