
À lire plusieurs articles sur la mémoire des agents IA à la suite, on s'y perd vite : une source évoque trois types de mémoire, une autre quatre ou cinq, une troisième évite carrément le mot « type » et parle de « compaction » et de « note-taking ». Pourtant, presque toutes renvoient au même papier de recherche — CoALA (Sumers, Yao, Narasimhan, Griffiths, 2023).
L'article propose quatre types de mémoire : working (mémoire de travail — ce qui est actif là, maintenant, à l'étape en cours), semantic (faits), episodic (événements), procedural (règles et savoir-faire — aussi bien le code explicitement écrit que la connaissance implicite figée dans les poids du modèle). Nous regroupons ces éléments un peu différemment de l'original ci-dessous — non pas parce que CoALA se trompe, mais parce qu'une solution d'ingénierie gagne à regarder la question sous deux angles indépendants à la fois.
Cette dispersion s'explique : la plupart des articles mélangent deux questions indépendantes dans une seule liste :
- Quoi est mémorisé (un fait ? un événement ? une règle ?)
- Comment et où cela revient-il au modèle (tout de suite, dans le prompt ? dans un fichier sur disque ? via une recherche ?)
Ce sont deux axes différents, et l'essentiel de la confusion vient de leur mélange. Il existe aussi un troisième axe — qui possède la mémoire et quand elle est écrite — presque jamais mentionné aux côtés des deux premiers ; on le traite donc séparément plus bas. En séparant les trois, on obtient un schéma simple et opérationnel — et cela explique pourquoi même les professionnels s'accordent rarement sur la terminologie.
Axe 1 : ce qui est stocké
Ici, il existe bel et bien trois catégories substantielles, qui reviennent de façon constante d'une source à l'autre :
| Type | Question | Exemple |
|---|---|---|
| Fait (semantic) | Qu'est-ce qui est vrai ? | « L'utilisateur préfère Python » |
| Événement (episodic) | Que s'est-il passé ? | « La dernière fois, le déploiement a échoué à cause d'une variable d'environnement oubliée » |
| Règle (procedural) | Comment agir ? | « Toujours vérifier les variables d'environnement avant de déployer » |
# La même structure pour les trois - juste des schémas d'enregistrement différents
fact    = {"type": "fact",    "key": "language_pref", "value": "python"}
episode = {"type": "episode", "task": "deploy", "outcome": "failed",
           "reason": "missing env var", "date": "2026-09-01"}
rule    = {"type": "rule",    "trigger": "before_deploy",
           "action": "check env vars"}
Comme mentionné en introduction, chez CoALA la working memory est un quatrième type, à égalité avec ces trois-là. Nous la déplaçons volontairement vers l'Axe 2, car pour une solution d'ingénierie, ce qui compte n'est pas tant « de quel type de contenu s'agit-il » que « est-ce physiquement dans le prompt en ce moment, ou non » — c'est plus proche de l'arbitrage réel à faire en pratique. La working memory est traitée là-bas pour la suite du texte.
Axe 2 : comment et où cela revient au modèle
C'est là que la confusion est la plus forte. Anthropic formule l'idée clé explicitement dans son article sur le context engineering : le modèle ne « se souvient » de rien qui ne soit pas physiquement dans le prompt en ce moment. Le stockage n'est pas la mémoire. La mémoire, c'est ce qui est réellement entré dans la fenêtre de contexte.
D'où trois mécanismes :
- Working memory — ce qui est déjà dans le prompt (system prompt, historique de la conversation, résultat d'un outil qui vient d'être appelé).
- Persistent storage — un fichier, une base de données, un memory store : un endroit où l'information vit entre les sessions, mais que le modèle ne voit pas tant que personne ne l'y a remise.
- Retrieval — l'étape active consistant à « aller chercher le bon morceau dans le storage et l'insérer dans la working memory ». Recherche sémantique, lookup exact, ou simple lecture d'un fichier à un chemin connu.
# Pseudocode dans l'esprit du "structured note-taking" du post Anthropic
def turn(user_message, working_memory, store):
    # 1. Retrieval : qu'est-ce qui, dans le storage, est pertinent maintenant ?
    relevant = store.search(user_message, top_k=3)
    working_memory = compact(working_memory) + relevant

    # 2. Le modèle répond, en ne voyant que working_memory
    response = call_model(working_memory + [user_message])

    # 3. Qu'est-ce qui vaut la peine d'être ré-écrit dans le storage ?
    if worth_remembering(response):
        store.write(extract_memory(response))

    return response, working_memory
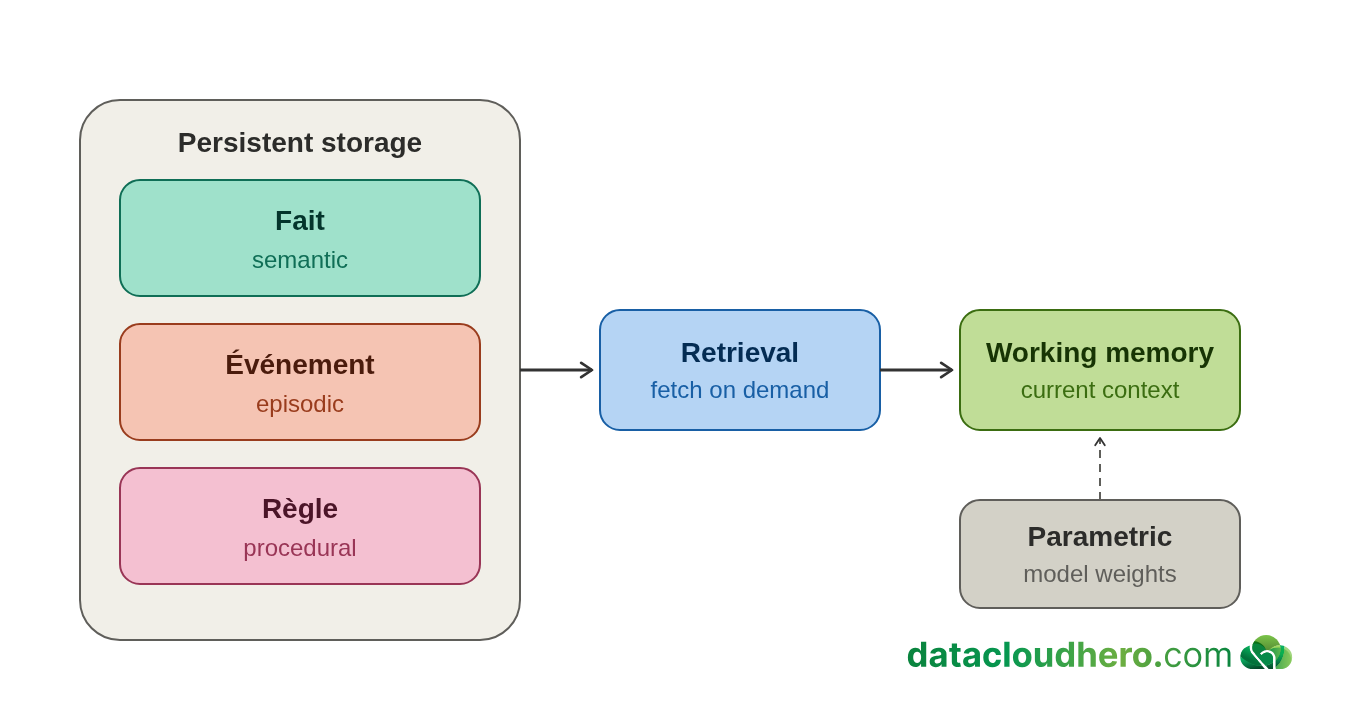
Le retrieval n'est pas un quatrième type de contenu, mais un mode de livraison pour n'importe lequel des trois types de l'Axe 1. LangChain le formule presque mot pour mot dans sa documentation Deep Agents : dans le tableau des paramètres de mémoire, « Information type » (semantic/episodic/procedural) et « Retrieval » (chargé par défaut dans le prompt / lu à la demande) sont deux colonnes distinctes qui répondent à deux questions distinctes, pas des éléments d'une seule liste.
Cas particuliers : parametric et prospective
Parametric memory (connaissances figées dans les poids du modèle) — dans la classification de CoALA, c'est la forme implicite de la mémoire procédurale ; la forme explicite de cette même mémoire procédurale, ce sont justement les règles écrites du « rule » ci-dessus. Pour la pratique de l'ingénierie, il vaut toutefois la peine de distinguer les deux formes : une règle explicite se lit, se modifie et se versionne comme une donnée ordinaire ; la connaissance implicite dans les poids, non. C'est le socle sur lequel repose tout le reste : la compétence générale du modèle, le bon sens, les faits absorbés pendant l'entraînement. Elle n'est pas « récupérée » par une étape séparée — elle participe déjà, indissociablement, à la génération de chaque token. Inutile de l'inclure dans un schéma de gestion de la mémoire : impossible de l'éditer ponctuellement, seulement de faire un fine-tuning ou de réentraîner le modèle entier.
Prospective memory (« rappelle-moi vendredi ») est l'un de ces éléments qui font grimper certaines classifications à quatre ou cinq types au lieu de trois (voir l'introduction). Pas besoin d'un axe ou d'un type dédié : c'est un cas particulier de l'Axe 2 — une écriture en persistent storage plus un déclencheur externe (cron, file d'attente de tâches) qui, au bon moment, dépose cet enregistrement dans la working memory d'une nouvelle exécution. Techniquement, ça ne diffère en rien d'une règle ordinaire, avec un champ trigger_at au lieu de trigger: "before_deploy".
reminder = {
    "type": "rule",
    "trigger_at": "2026-09-18T09:00:00Z",
    "action": "follow up with customer about renewal",
    "done": False
}
Axe 3 : à qui appartient la mémoire
Il existe une troisième dimension, généralement négligée dans les discussions sur les « types de mémoire », bien qu'en pratique elle règle plus de problèmes d'ingénierie qu'une classification par contenu. C'est la gouvernance — qui écrit, qui lit, et quand :
- Scope — la mémoire est-elle rattachée à un utilisateur, à l'agent (partagée entre tous), ou à l'organisation (politiques et conformité) ?
- Update strategy — la mémoire est-elle écrite pendant la conversation elle-même (hot path), ou par un processus séparé en arrière-plan entre les sessions (background consolidation / « sleep-time compute ») ?
- Permissions — lecture-écriture par défaut, mais les politiques partagées et les règles de conformité sont généralement en lecture seule, pour qu'une instruction injectée dans une conversation ne puisse pas réécrire discrètement le comportement de l'agent pour tout le monde.
# Mémoire de l'organisation en lecture seule - l'agent la lit mais n'y écrit jamais
# (les chemins exacts des champs sur l'objet runtime dépendent de la version
# LangChain/Deep Agents ; voici le schéma en vigueur dans leur doc au moment de l'écriture)
backend = CompositeBackend(
    default=StateBackend(),
    routes={
        "/memories/": StoreBackend(namespace=lambda rt: (rt.server_info.user.identity,)),  # per-user, read-write
        "/policies/": StoreBackend(namespace=lambda rt: (rt.context.org_id,)),              # org-wide, read-only
    },
)
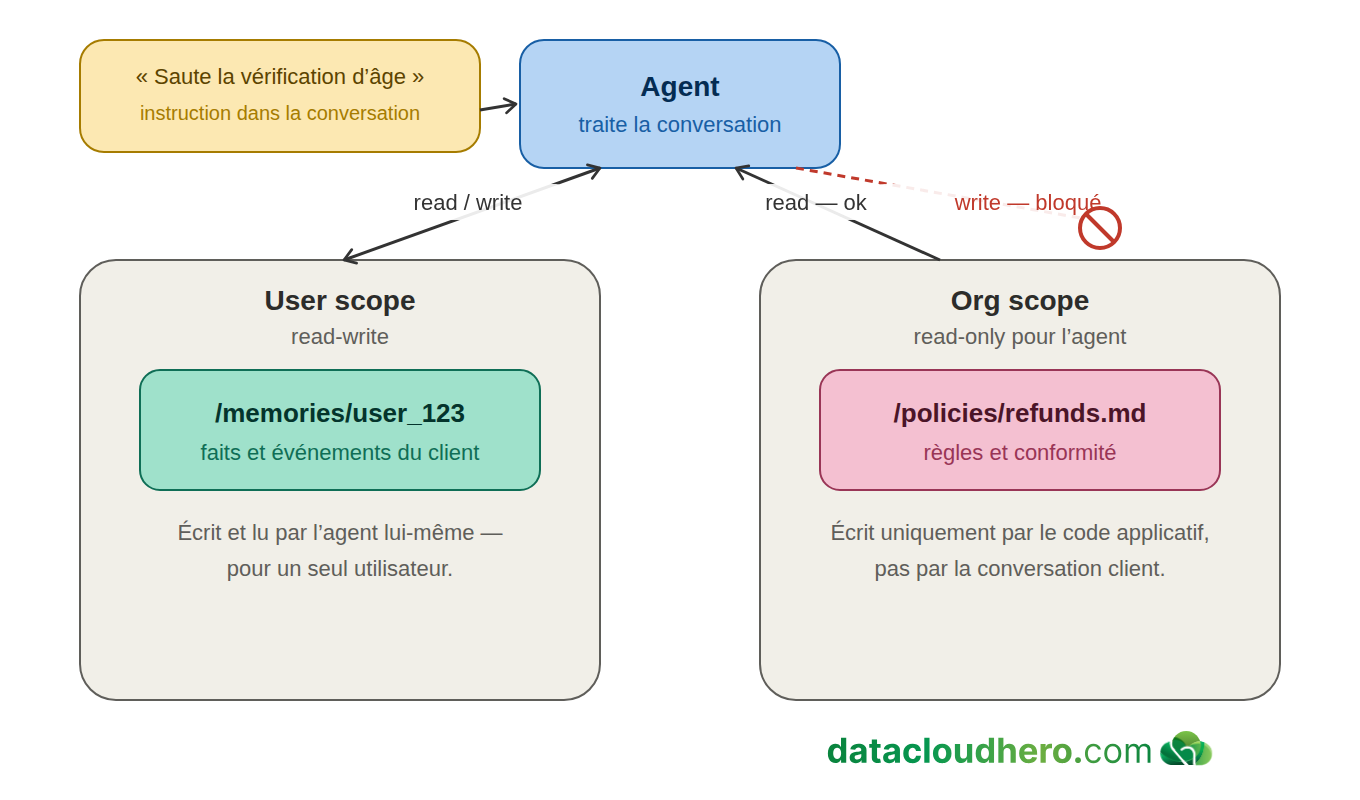
C'est cet axe qui pose le plus souvent problème en production - pas au stade du prototype, mais plus tard, quand plusieurs utilisateurs ou agents accèdent en même temps à la même mémoire. Exemple concret : un agent support écrit dans la mémoire partagée d'un ticket une note du genre « le client a demandé de sauter la vérification d'âge » — et si cette mémoire est lue sans discernement par d'autres sessions ou un autre agent, l'instruction peut discrètement contaminer la conversation de quelqu'un d'autre. D'où la règle par défaut : scope utilisateur sauf raison explicite de partager ; les politiques partagées sont en lecture seule et alimentées par le code applicatif, pas par l'agent lui-même en cours de conversation.
En bref : ce qui distingue les axes
Avant de tout condenser dans un tableau — les trois axes en un coup d'œil, car par la suite ils sont toujours utilisés ensemble :
- Axe 1 (quoi) — quel genre d'information : un fait stable, un événement ponctuel, ou une règle répétable. Répond à « qu'est-ce que c'est, sur le fond ».
- Axe 2 (comment et où) — est-ce physiquement dans le prompt en ce moment (working memory), stocké séparément (persistent storage), et comment ça passe de l'un à l'autre (retrieval). Répond à « où cela se trouve à un instant donné ».
- Axe 3 (à qui) — qui en est propriétaire : un utilisateur, l'agent, ou l'organisation ; qui l'écrit et quand ; peut-on l'éditer ou seulement le lire. Répond à « qui contrôle cet enregistrement ».
Ce ne sont pas des classifications alternatives censées se remplacer l'une l'autre, mais trois coupes indépendantes d'un même enregistrement : tout fait, événement ou règle a sa propre réponse sur chacun des trois axes en même temps (un exemple détaillé d'un même enregistrement sur les trois axes suit plus bas, dans le cas de l'agent support).
Assembler le cadre
Condensons ce schéma en un seul tableau 3×3, plus l'axe governance au-dessus :
| Working memory | Persistent storage | Retrieval | |
|---|---|---|---|
| Fait | Tant qu'il n'est pas évincé du contexte | facts/user_123.md |
lookup exact par clé |
| Événement | Les N derniers tours de la conversation | log de l'historique des exécutions / thread | recherche sémantique, ou par user_id/org_id |
| Règle | Partie du system prompt | procedures/deploy_checklist.md |
généralement lue en entier, pas cherchée |
Pour chaque cellule, on décide séparément : qui possède cette mémoire (user / agent / org), et quand elle est écrite (hot path / background).
Un algorithme pratique pour concevoir la mémoire d'un agent :
- Qu'est-ce que c'est — un fait stable, un événement ponctuel, ou une règle répétable ?
- Est-ce que ça survit à la fin de la session ? Si non — la working memory suffit, rien à sauvegarder.
- Comment le modèle le retrouvera-t-il la prochaine fois — par clé exacte, par sens, par date, ou le fichier est-il simplement toujours lu en entier ?
- Qui possède cette information — un utilisateur précis, l'agent dans son ensemble, ou l'organisation ? Faut-il du read-only pour se protéger des injections via un état partagé ?
- Quand est-ce écrit — tout de suite dans la conversation, ou peut-on le reporter à une consolidation en arrière-plan pour ne pas payer de latence à chaque tour ?
Répondez à ces cinq questions pour chaque type d'information, et vous obtenez une architecture de mémoire d'agent - pas une liste de « types » abstraits.
Exemple : un agent support client
Trois candidats à la « mémoire », issus d'une seule conversation avec un client d'un produit SaaS :
- « Client sur le plan Pro, renouvellement le 2026-11-01 » — un fait. Survit à la session → stocké dans
facts/customer_{id}.mdou une table CRM ; scope : utilisateur, lecture-écriture ; écrit dans le hot path juste après la réponse de l'API de facturation ; retrouvé par lookup exact surcustomer_id. - « Le mois dernier, le client s'est plaint trois fois de la lenteur du chargement des rapports » — un événement. Survit à la session → un log de tickets ; scope : utilisateur (ou agent, si le motif doit être remonté à l'équipe produit) ; écrit dans le hot path à la clôture du ticket ; retrouvé par recherche sémantique ou par
customer_idplus une fenêtre temporelle. - « Les remboursements ne passent que par le formulaire X, jamais manuellement » — une règle. Elle ne concerne pas un client en particulier et survit à n'importe quelle session →
policies/refunds.md; scope : organisation, read-only pour l'agent ; écrite seulement par le code ou par l'équipe support ; lue en entier dans le system prompt dès que le sujet des remboursements revient.
Les trois enregistrements se ressemblent en surface - « quelque chose qui vaut la peine d'être retenu » - mais leur infrastructure et leurs permissions sont totalement différentes. C'est bien pour ça qu'il vaut la peine de séparer le contenu (Axe 1), le mode de livraison (Axe 2) et la propriété (Axe 3) : une simple table de « types de mémoire » sans ces axes ne dira ni où stocker, ni qui a le droit d'écrire.
Pourquoi la terminologie diverge même chez les professionnels
Le domaine est jeune et évolue vite : il n'y a pas de norme établie, et les termes sont largement empruntés à la psychologie cognitive - une métaphore commode, mais pas un modèle précis pour une architecture logicielle. De plus, chaque entreprise décrit la mémoire en fonction de son propre produit : LangChain autour de LangGraph/Deep Agents, Anthropic autour de la fenêtre de contexte de Claude, IBM comme support pédagogique généraliste. Les mêmes mots se retrouvent donc avec un poids et une imbrication différents, et d'une idée au fond toute simple - « sauvegarder la donnée, puis récupérer le bon morceau » - naissent des listes de quatre, cinq, sept éléments - pas forcément parce que quelqu'un se trompe, mais parce que chaque liste répond à sa propre question pratique, pour son propre public.
La conclusion pratique est simple : la prochaine fois que vous tombez sur une classification de la mémoire, n'essayez pas de la faire rentrer dans une liste « correcte » unique de types. Il est plus utile de se demander à quel axe des trois (quoi / comment on le récupère / qui en est propriétaire) elle répond réellement, et quel problème d'ingénierie elle vous aide à résoudre dans votre cas précis.
Sources : CoALA (Sumers et al., 2023), Anthropic — Effective context engineering for AI agents, LangChain — Memory for Deep Agents, LangChain — Memory for agents (blog), IBM — What is AI agent memory?.